
Paginering på webshops: de fem regler, vi altid følger
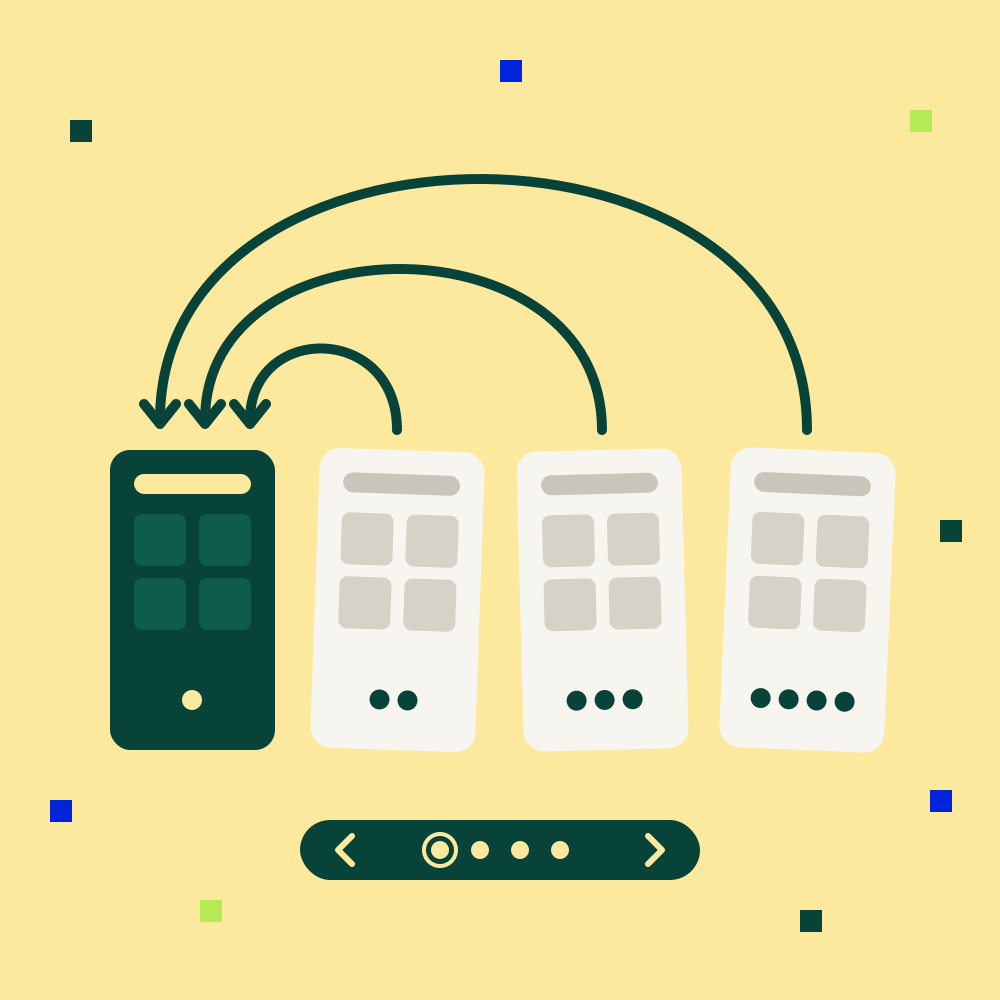
Google anbefaler self-canonical på side 2 og frem. Vi sætter canonical til side 1. Her er de fem regler, vi bruger på kategorisider, hvorfor vi afviger fra Googles dokumentation, og hvad det kræver, når man gør det.
Hassan Aziz
Partner & Projektleder, Bullmade
Hvad paginering skal løse på en kategoriside
En kategori med 600 produkter og 24 pr. side giver 25 URL'er, der alle viser den samme kategori. Kun den første af dem har en chance for at rangere på kategoriens søgeord. Resten findes af to grunde: kunden skal kunne bladre, og Googlebot skal kunne finde produkterne.
Det er de to opgaver, pagineringen skal løse, og de trækker i hver sin retning. Side 2 til 25 skal være crawlbare nok til, at produkterne bliver fundet, men de må ikke blive så synlige i indekset, at de konkurrerer med side 1 eller bruger crawl på sider, der aldrig skal lande en besøgende.
Vi har fem faste regler for det:
| Regel | Side 1 | Side 2 og frem |
|---|---|---|
| 1. Canonical | Self-canonical til den rene URL | Peger på den rene side 1 |
| 2. H1 | Kategoriens navn | Identisk med side 1 |
| 3. Sidetitel | Kategoriens titel | Samme titel med (2), (3) osv. |
| 4. Kategoritekst | Vises | Vises ikke |
| 5. Tomme sider | Ikke relevant | Sider uden varer indekseres ikke |
Regel 1 går imod Googles egen dokumentation. Det gennemgår vi først, fordi de fire andre regler giver mest mening, når man har set den.
Filtre og facetter er et emne for sig. Vi har skrevet om dem i artiklen om facetteret navigation, og her nævner vi dem kun, hvor de rammer pagineringen.
Googles anbefaling, og hvor vi afviger
Googles side om paginering på webshops er klar. Hver side skal have sin egen URL, for eksempel med ?page=n, og der står direkte, at man ikke skal bruge første side i en pagineret serie som canonical. Hver side skal i stedet have sin egen canonical URL.
Begrundelsen ligger i, hvordan canonical er tænkt. Et canonical-tag fortæller Google, hvilken af flere næsten ens sider der er den rigtige version. Side 2 og side 1 i en kategori er ikke ens: de har samme skabelon, men forskellige produkter. Google beskriver canonical som et stærkt signal og ikke som en ordre, og når to sider tydeligt har forskelligt indhold, kan Google vælge at se bort fra tagget.
Så langt er vi enige med Google. Vi sætter alligevel canonical til side 1, og det er et bevidst valg med en pris, som vi beskriver nedenfor. Det er ikke en misforståelse af dokumentationen.
Regel 1: Canonical på side 2 og frem peger på side 1
Vi har tre grunde til at gå imod anbefalingen.
Konsolidering. Interne og eksterne links rammer af og til side 2 eller 3, typisk fra gamle kampagner, fra produktsider med et brødkrummespor, der har husket en side, eller fra en kunde, der har delt et link. Med canonical til side 1 beder vi Google om at samle de signaler på den side, der faktisk skal rangere.
Kannibalisering. Side 2 til N har samme H1, næsten samme titel og samme navigation som side 1. Bliver de indekseret som selvstændige sider, kan de dukke op på kategoriens søgeord i stedet for side 1. En besøgende, der lander på side 7 af "vinterjakker", får de 24 jakker, der lå syvendebedst i sorteringen, og ingen kategoritekst.
Crawl på store kataloger. En shop med 300 kategorier og i snit 15 sider pr. kategori har 4.200 pagineringssider ud over de 300 kategorisider. Kombineres de med sortering og filtre, bliver tallet hurtigt flercifret i tusinder. På store sites er crawl-budget en reel begrænsning, og vi vil hellere have, at Googlebot bruger besøgene på produktsider og kategorier end på side 14 af en liste.
I praksis ser det sådan ud i <head> på side 3:
<title>Vinterjakker til herrer (3) | Butiksnavn</title>
<link rel="canonical" href="https://www.example.dk/herre/vinterjakker">
<meta name="robots" content="index, follow">
Bemærk den sidste linje. Vi kombinerer aldrig canonical til side 1 med noindex på samme side. Det er to forskellige beskeder, og Google skriver selv i sin canonical-dokumentation, at noindex ikke bør bruges til at styre valget af canonical inden for samme site. Linkene på side 3 skal stadig kunne følges.
Hvad reglen koster, og hvordan vi betaler prisen
Prisen er ret konkret. Når Google følger vores canonical, bliver side 2 til N ikke indekseret som selvstændige sider. Vi kan så ikke regne med, at Google bruger dem som vej ind til produkterne, og et produkt, der kun er linket fra side 11 af en kategori, risikerer at blive fundet sent eller slet ikke.
Følger Google den ikke, fordi siderne er for forskellige, ender vi med det, Google anbefalede i forvejen, bare med en ekstra statusmeddelelse i Search Console. Det er ikke skadeligt, men så har reglen ikke gjort noget.
Begge udfald betyder, at pagineringen ikke må være den eneste vej til et produkt. Derfor følger fire ting altid med reglen:
- XML-sitemap med alle indekserbare produkter. Ikke pagineringssiderne, kun produkter og kategorier. Google nævner selv sitemap og Merchant Center-feed som måder at få produkter fundet på, når de ligger dybt i lister.
- Underkategorier, der gør listerne kortere. En kategori med 40 sider er som regel en kategori, der mangler en opdeling. Det hjælper både kunden og crawlingen, og underkategorierne kan rangere på egne søgninger.
- Flere produkter pr. side. Se tabellen nedenfor.
- Interne links fra andre steder end listen. Relaterede produkter på produktsiden, "andre har også købt", brands, guides og kampagnesider.
Antallet af produkter pr. side er den billigste justering. Her er en kategori med 1.200 produkter:
| Produkter pr. side | Antal sider | Klik fra side 1 til sidste side med kun næste-link |
|---|---|---|
| 24 | 50 | 49 |
| 48 | 25 | 24 |
| 96 | 13 | 12 |
Går I fra 24 til 48, halveres dybden, og vægten på siden stiger mindre, end de fleste regner med, når billederne lazy-loades. Hold øje med LCP og INP, når I skruer op. Vi har skrevet om rækkefølgen i Core Web Vitals for webshops.
Pagineringslinkene skal også springe. En navigation med 1, 2, 3, ..., 50 og et par numre omkring den aktuelle side gør, at ingen side ligger mere end en håndfuld klik fra side 1.
Hvornår I skal vælge self-canonical i stedet
Vores regel er en standard og ikke et dogme. Der er sites, hvor Googles anbefaling er det rigtige valg, og den afgørende faktor er, om produkterne kan findes uden om pagineringen.
| Situation | Vores valg | Hvorfor |
|---|---|---|
| Kategori under 5 sider, produkter i sitemap og linket fra andre steder | Canonical til side 1 | Lav risiko, og side 1 får signalerne |
| Stort katalog med tusindvis af pagineringssider og sortering | Canonical til side 1 | Crawl bruges på produkter i stedet for lister |
| Produkter, der kun er linket fra listen og ikke ligger i sitemap | Self-canonical, indtil sitemap og links er på plads | Pagineringen er eneste vej ind |
| Hyppig udskiftning af sortiment, fx outlet eller restsalg | Self-canonical | Nye varer skal findes hurtigt, og de ligger ofte dybt |
| Blog, nyheder eller arkiver | Self-canonical | Ældre artikler har ofte kun arkivet som indgang |
| Google vælger alligevel side 2+ som canonical i stor stil | Self-canonical | Signalet bliver ikke fulgt, og I får ikke gevinsten |
Den korte version: kan I ikke svare ja til, at hvert indekserbart produkt ligger i sitemap og har mindst ét internt link uden for pagineringen, skal I bruge self-canonical, til det er på plads.
Uanset valg gælder Googles øvrige anbefalinger: hver side har sin egen URL, der linkes sekventielt med rigtige <a href>-links, og alle sider linker tilbage til side 1.
Regel 2 og 3: Samme H1 og titel med sidenummer
H1 er identisk på alle sider i serien. Vi skriver ikke "Vinterjakker side 3" i H1, fordi siden handler om det samme, og fordi en ændret H1 er en lille invitation til at behandle side 3 som et selvstændigt emne.
Sidetitlen må gerne få et nummer på, og vi sætter det i parentes til sidst: "Vinterjakker til herrer (3)". Google skriver faktisk, at sider i en pagineret serie godt må have samme titel og beskrivelse, så nummeret er ikke et krav. Vi bruger det af to grunde. Det gør det lettere at se i crawl-værktøjer og i Search Console, hvilken side man kigger på, og hvis Google ignorerer canonical og viser side 3 i søgeresultatet, kan brugeren se, at det ikke er starten af listen.
Meta-beskrivelsen er den samme som på side 1.
Regel 4: Kategoriteksten kun på side 1
Kategoriteksten, FAQ og eventuel guide-sektion vises kun på side 1. På side 2 og frem står H1, produktlisten og navigationen.
Det har to virkninger. Teksten findes kun på én URL, så der er ingen tvivl om, hvilken side der dækker emnet. Og side 2 og frem bliver det, de er: en fortsættelse af listen. En kunde, der klikker til side 2, har allerede set teksten eller sprunget den over, og den skubber produkterne ned.
Fejlen her er som regel teknisk. Mange temaer udskriver kategoribeskrivelsen i skabelonen uden at tjekke sidenummeret. I PrestaShop og WooCommerce ligger det typisk i kategoriskabelonen, i Shopify i collection-sektionen. Tjek det ved at åbne side 2 og søge efter den første sætning i kategoriteksten i kildekoden, ikke kun på skærmen, for nogle temaer skjuler den med CSS og udskriver den alligevel.
Regel 5: Tomme sider bliver ikke indekseret
Der er to slags tomme sider, og de skal behandles forskelligt.
Sider ud over den sidste side. Har kategorien 25 sider, og nogen rammer ?page=40, skal serveren svare 404. Mange platforme svarer 200 med en tom liste eller med indholdet fra side 1. Begge dele er forkerte. En tom side med 200 ender som soft 404 i Search Console, og en kopi af side 1 på en vilkårlig URL er en duplikat, der aldrig forsvinder. URL'erne opstår, når sortimentet skrumper: side 25 fandtes i sidste måned, og Google har den stadig i sin liste. Med 404 fjerner Google URL'en fra indekset og crawler den gradvist sjældnere.
Vi bruger ikke 301 til side 1 her. Det sender brugeren et forkert sted hen uden forklaring.
Kategorier med 0 varer. Er kategorien tom midlertidigt, fx en sæsonkategori i lavsæson, beholder vi 200, sætter noindex og viser relaterede kategorier, så siden er brugbar. Er den tom permanent, 301-redirecter vi til nærmeste overordnede kategori og fjerner den fra menu og sitemap. En kategori, der har stået tom og noindex i et halvt år, er ikke længere midlertidig.
Reglen gælder også filtrerede visninger med 0 resultater. Den del er beskrevet i artiklen om facetter.
URL'er: ?page=1, sortering og fragmenter
Tre URL-fejl går igen på næsten alle de shops, vi gennemgår.
?page=1 som duplikat. Linket "1" i pagineringen og "forrige" på side 2 peger ofte på /vinterjakker?page=1. Det er en eksakt kopi af /vinterjakker. Ret linkene, så de peger på den rene URL, og 301-redirect ?page=1 til den rene URL, så gamle links også bliver samlet.
Sortering. ?order=price viser de samme produkter i en anden rækkefølge, og her er der ingen diskussion: det er en duplikat, og canonical skal pege på den usorterede version. Kombineres sortering med sidetal, som i ?order=price&page=3, peger canonical på den rene side 1, fordi både sortering og side er variationer af den samme kategori. Google foreslår noindex eller robots.txt for sorteringsvarianter. Vi foretrækker canonical, så længe der ikke er tale om voldsomme mængder, fordi en URL, der er spærret i robots.txt, ikke kan crawles, og så kan Google heller ikke se canonical på den. På meget store sites, hvor sorteringsvarianterne æder crawl, spærrer vi dem i robots.txt og accepterer, at de få eksterne links til dem ikke bliver samlet.
Fragmenter. #page=2 virker ikke som paginering for Google. Alt efter # bliver ignoreret, og Google skriver, at Googlebot muligvis ikke følger et link, der kun adskiller sig efter #, fordi den tror, den allerede har hentet siden.
Hold desuden parametrenes rækkefølge fast. ?page=2&order=price og ?order=price&page=2 er to URL'er for Google, selv om de viser det samme.
Uendelig scroll og "indlæs flere"
Begge mønstre er fine for kunden og ofte bedre end sidetal på mobil. Problemet er, at de typisk er bygget med JavaScript, og Google skriver direkte, at crawleren ikke klikker på knapper og generelt ikke udløser JavaScript, der kræver en brugerhandling. En "indlæs flere"-knap, der henter produkt 25 til 48 via et API-kald, er usynlig for Googlebot.
Løsningen er at bygge pagineringen først og lægge scroll eller knappen ovenpå:
- Hver side i listen har en rigtig URL,
?page=2,?page=3og så videre, som også fungerer, når man åbner den direkte. - Knappen er et
<a href="?page=2">, som JavaScript fanger og erstatter med et asynkront kald. Uden JavaScript virker den som et almindeligt link. - Når næste blok er indlæst, opdateres adresselinjen med
history.pushStateellerreplaceState, så en kunde, der deler linket eller trykker tilbage, lander det rigtige sted. - Regel 1 til 5 gælder stadig for de URL'er, der ligger under.
Test det ved at slå JavaScript fra i browseren og se, om I kan komme til side 3. Eller kig i den gengivne HTML i URL-inspektionen og søg efter href til næste side. Står der kun en <button> uden href, er produkterne efter side 1 ikke linket for Google.
Det samme gælder pagineringslinks generelt. Google kan kun crawle <a>-elementer med en href. Links bygget som <span onclick>, <a> uden href eller href="javascript:..." bliver ikke fulgt.
rel=next og rel=prev
Google meddelte i marts 2019, at rel="next" og rel="prev" ikke havde været brugt i indekseringen i flere år, og fjernede dem fra dokumentationen. Den nuværende pagineringsside skriver det samme: Google bruger ikke længere tagsene, men andre søgemaskiner kan stadig bruge dem.
Vi fjerner dem ikke, hvor de allerede findes og er korrekte. De koster ingenting, og Bing og andre kan have gavn af dem. Men vi bygger dem ikke ind som en løsning på noget i Google, og et forkert rel=next, der peger på en side, der ikke findes, er værre end slet intet.
Det, der overtog rollen for Google, er almindelige <a href>-links mellem siderne. Er de i orden, har I det, Google bruger.
Sådan tester I det i Search Console
Vi tjekker fire ting, når reglerne er sat op, og igen efter 4 til 8 uger, når Google har nået at crawle siderne.
URL-inspektion på side 2 af en stor kategori. Under sideindeksering står både den canonical, I har angivet, og den, Google har valgt. Er de ens, følger Google reglen. Peger Googles valg på side 2 selv, har Google vurderet, at siderne er for forskellige, og så gælder regel 1 ikke i praksis. Bemærk, at livetesten ikke viser Googles canonical-valg. Det afgøres ved indeksering, så I skal kigge på den indekserede version.
Sideindekseringsrapporten. Statussen "Duplicate, Google chose different canonical than user" (på dansk en tilsvarende duplikat-status) er der, I ser afvigelserne i stor skala. Filtrér eksemplerne på page=. Er det pagineringssider, der lander her, ved I, at Google overstyrer jer. Er det i stedet side 1 eller produktsider, er der en fejl i opsætningen.
URL-inspektion på et produkt, der ligger dybt. Vælg et produkt, der kun er synligt på en af de sidste sider i sin kategori. I afsnittet om, hvordan siden blev fundet (Discovery), kan I se, om Google har fundet det via sitemap, og hvilke henvisende sider der står. Er det ikke indekseret efter et par måneder, er det et tegn på, at pagineringen var den eneste vej ind.
Soft 404 og ikke fundet. Søg i rapporten efter page=. Pagineringssider under soft 404 betyder, at der står tomme sider med 200 et sted. Under "Ikke fundet (404)" er de forventede efter regel 5, og det er ikke noget, der skal rettes.
Kør også et crawl med Screaming Frog eller tilsvarende og sammenlign antallet af produkter, crawleren finder via kategorierne, med antallet i sitemap. Mangler der produkter i crawlet, er der et linkproblem, uanset hvad canonical siger. Står I midt i en større oprydning, er det typisk en del af en teknisk SEO-audit.
Tjekliste
- Side 1 har self-canonical til den rene URL uden parametre.
- Side 2 og frem har canonical til den rene side 1, eller self-canonical hvis jeres site falder under undtagelserne ovenfor.
- Ingen side kombinerer canonical til side 1 med noindex.
- H1 er identisk på alle sider i serien. Titlen har (2), (3) osv. til sidst.
- Kategoriteksten findes kun i kildekoden på side 1.
?page=1301-redirecter til den rene URL, og pagineringen linker aldrig til den.- Sider ud over den sidste side svarer 404.
- Midlertidigt tomme kategorier har 200 og noindex. Permanent tomme kategorier redirecter til forælderen.
- Sortering har canonical til den usorterede version, og parametrene står i fast rækkefølge.
- Ingen sidetal i fragmenter efter
#. - Pagineringslinks er
<a href>, også bag "indlæs flere" og uendelig scroll. - Alle indekserbare produkter ligger i XML-sitemap og har mindst ét internt link uden for listen.
- Kategorier med mere end 10 til 15 sider bliver vurderet til opdeling i underkategorier.
- URL-inspektion og sideindekseringsrapporten er tjekket 4 til 8 uger efter ændringen.
Arbejder I med kategoristruktur og indeksering på en større shop, er det den del af webshop-SEO, vi bruger mest tid på i opstarten.
Kilder
- Google Search Central: Pagination, incremental page loading, and their impact on Google Search
- Google Search Central: How to specify a canonical URL with rel="canonical" and other methods
- Google Search Central: What is URL canonicalization
- Google Search Central: Make your links crawlable
- Google Search Central: How HTTP status codes and network errors affect Google Search
- Search Console Hjælp: URL-inspektionsværktøjet
- Google Search Central Blog: Pagination with rel="next" and rel="prev" (med opdateringsnote)
- Search Engine Journal: Google stopped supporting rel=prev/next in search indexing years ago (21. marts 2019)
Relaterede artikler om Search (SEO)
Læs også
01 Kritisk sikkerhedshul i PHP: opdatér til 8.4.27, 8.3.36, 8.2.35 eller 8.5.12 nu 02 PrestaShop og det kritiske PHP-hul: mange shops kører på en PHP uden rettelse 03 Facebook hacket: hvad gør jeg med virksomhedens side og Instagram?